テクニカルSEOの問題を調査する方法
ステータスとインデックス登録可能性を確認
顧客にとって重要なURL、つまり主要なランディングページから始めます。 商品ページと代表的なテンプレート。 目標がクロール可能性、インデックス登録、コンテンツ品質、ページパフォーマンスのいずれなのかを記録します。
クロール設定を固定し、ページ数の上限を明示します。途中で停止したクロールでは、サイト上のすべてのページに問題がないことを確認できません。
対象、レンダリングの選択、収集ルートを日付付きで記録してください。後日の比較で結果を説明しやすくなり、異なる条件で収集した結果を混在させずに済みます。
ページのコンテンツを読み取る前に、HTTPレスポンスを確認してください。リダイレクト、エラーレスポンス、リクエストのブロックには、HTMLページの取得成功とは異なる調査が必要です。
内部リンクを確認する
返されたドキュメントのrobotsメタタグとcanonical URLを確認してください。noindexディレクティブは検索から意図的に除外するもので、canonicalは優先するURLを示します。両者は異なる目的で使われます。
テンプレートが多数のURLで同じ問題を生成する場合は、代表的なページを手動で確認します。各ページを個別に編集するより、テンプレートを修正する方が効果的な場合があります。
リンク切れを参照元ページとリンク先ごとに分類します。ユーザーやクローラーが重要なコンテンツにたどり着けなくなるリンクを優先します。
内部リンク先を優先URLのセットと照合します。リダイレクトの連鎖に頼らず、正規ページへ直接リンクしてください。
メタデータと重複を確認
範囲を限定したクロールで見つからないページは、クロール対象外である可能性があります。孤立ページまたは削除済みページと判断する前に、URLを個別に確認してください。
- オンページ品質 - クエリに正しく回答するコンテンツ
- 検索可視性、需要、リンク、ページの健全性、AIの引用にまたがる調査では、On-Page APIに関連データセットを組み合わせてください。
レンダリングとパフォーマンスのテストを選択
修正を優先順位付けし、検証する
各ページの目的を正確に示すタイトルと説明を使用してください。すべての製品で同じ汎用的な説明を繰り返しても、ユーザーが各製品を見分ける助けにはなりません。
重複候補を主要なコンテンツと検索意図で比較します。統合するか、廃止したルートをリダイレクトするか、実質的に異なる情報を作成するかを判断します。
同じ優先URLを使用する 内部リンクにおける、 canonicalタグとサイトマップ。シグナルが競合すると、意図されたURLの解釈が難しくなります。
監査の対象範囲を定義する
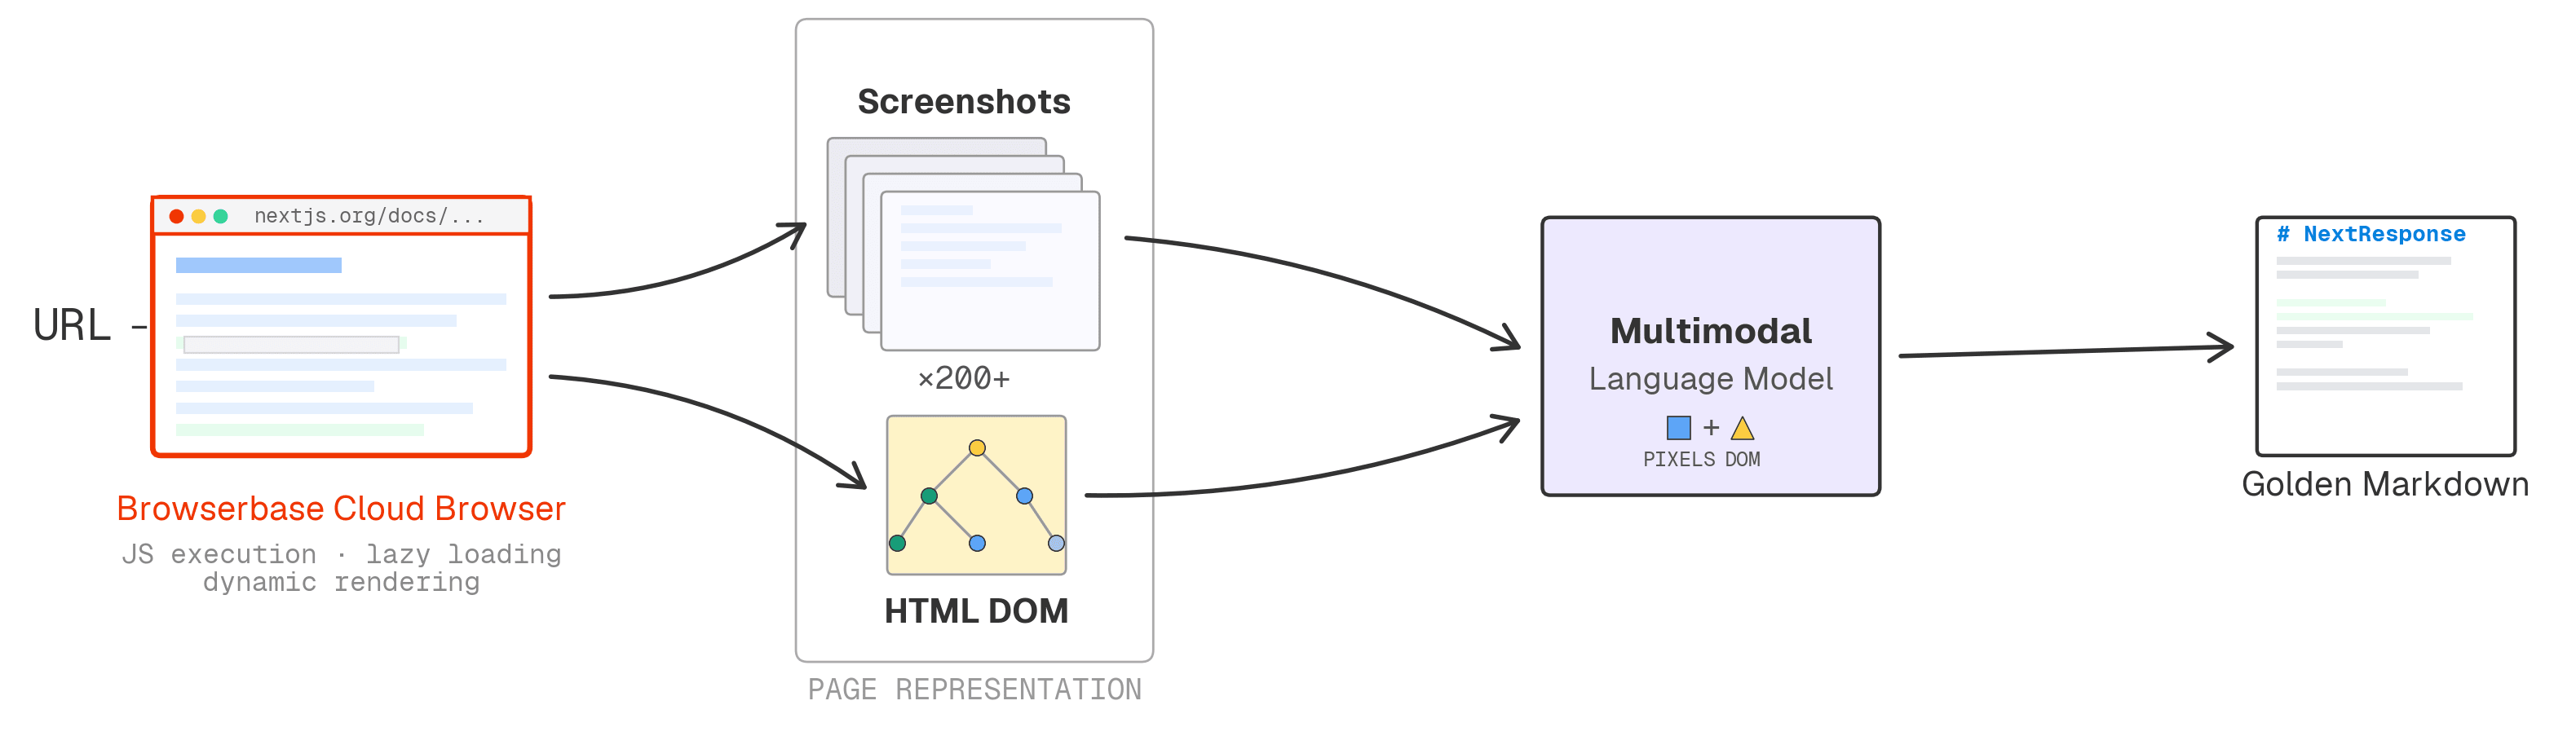
必要なコンテンツを取得できる、最もシンプルなデータ収集方法から始めましょう。JavaScriptに依存するテンプレートではブラウザが必要になる場合がありますが、ブラウザを使ったデータ収集には異なるリソース要件があります。
- 正しく取得できても、書式が崩れる
- 構造を完全に維持したまま、ページの半分を削除する
Lighthouseの結果は、特定の条件下で実施したラボ測定として解釈してください。フィールド測定なしに、実ユーザーのCore Web Vitalsの結果として報告しないでください。
- キーワード、検索エンジン、地域、言語、デバイスを設定します。各観測でこれらの設定を保持することで、ランキング比較の対象を同じオーディエンスと市場に揃えられます。
- オーガニック検索、マップ、ニュース、画像、ショッピング、その他の対応する検索結果タイプを調査します。アイテムタイプを使って、各エンドポイントが返すフィールドを解釈します。
ステータスとインデックス登録可能性を確認
読み込みの問題を調査する際は、画像、フォント、サードパーティのリソースを確認してください。条件を揃えて同じページを再テストしてください。 リソースを変更する。
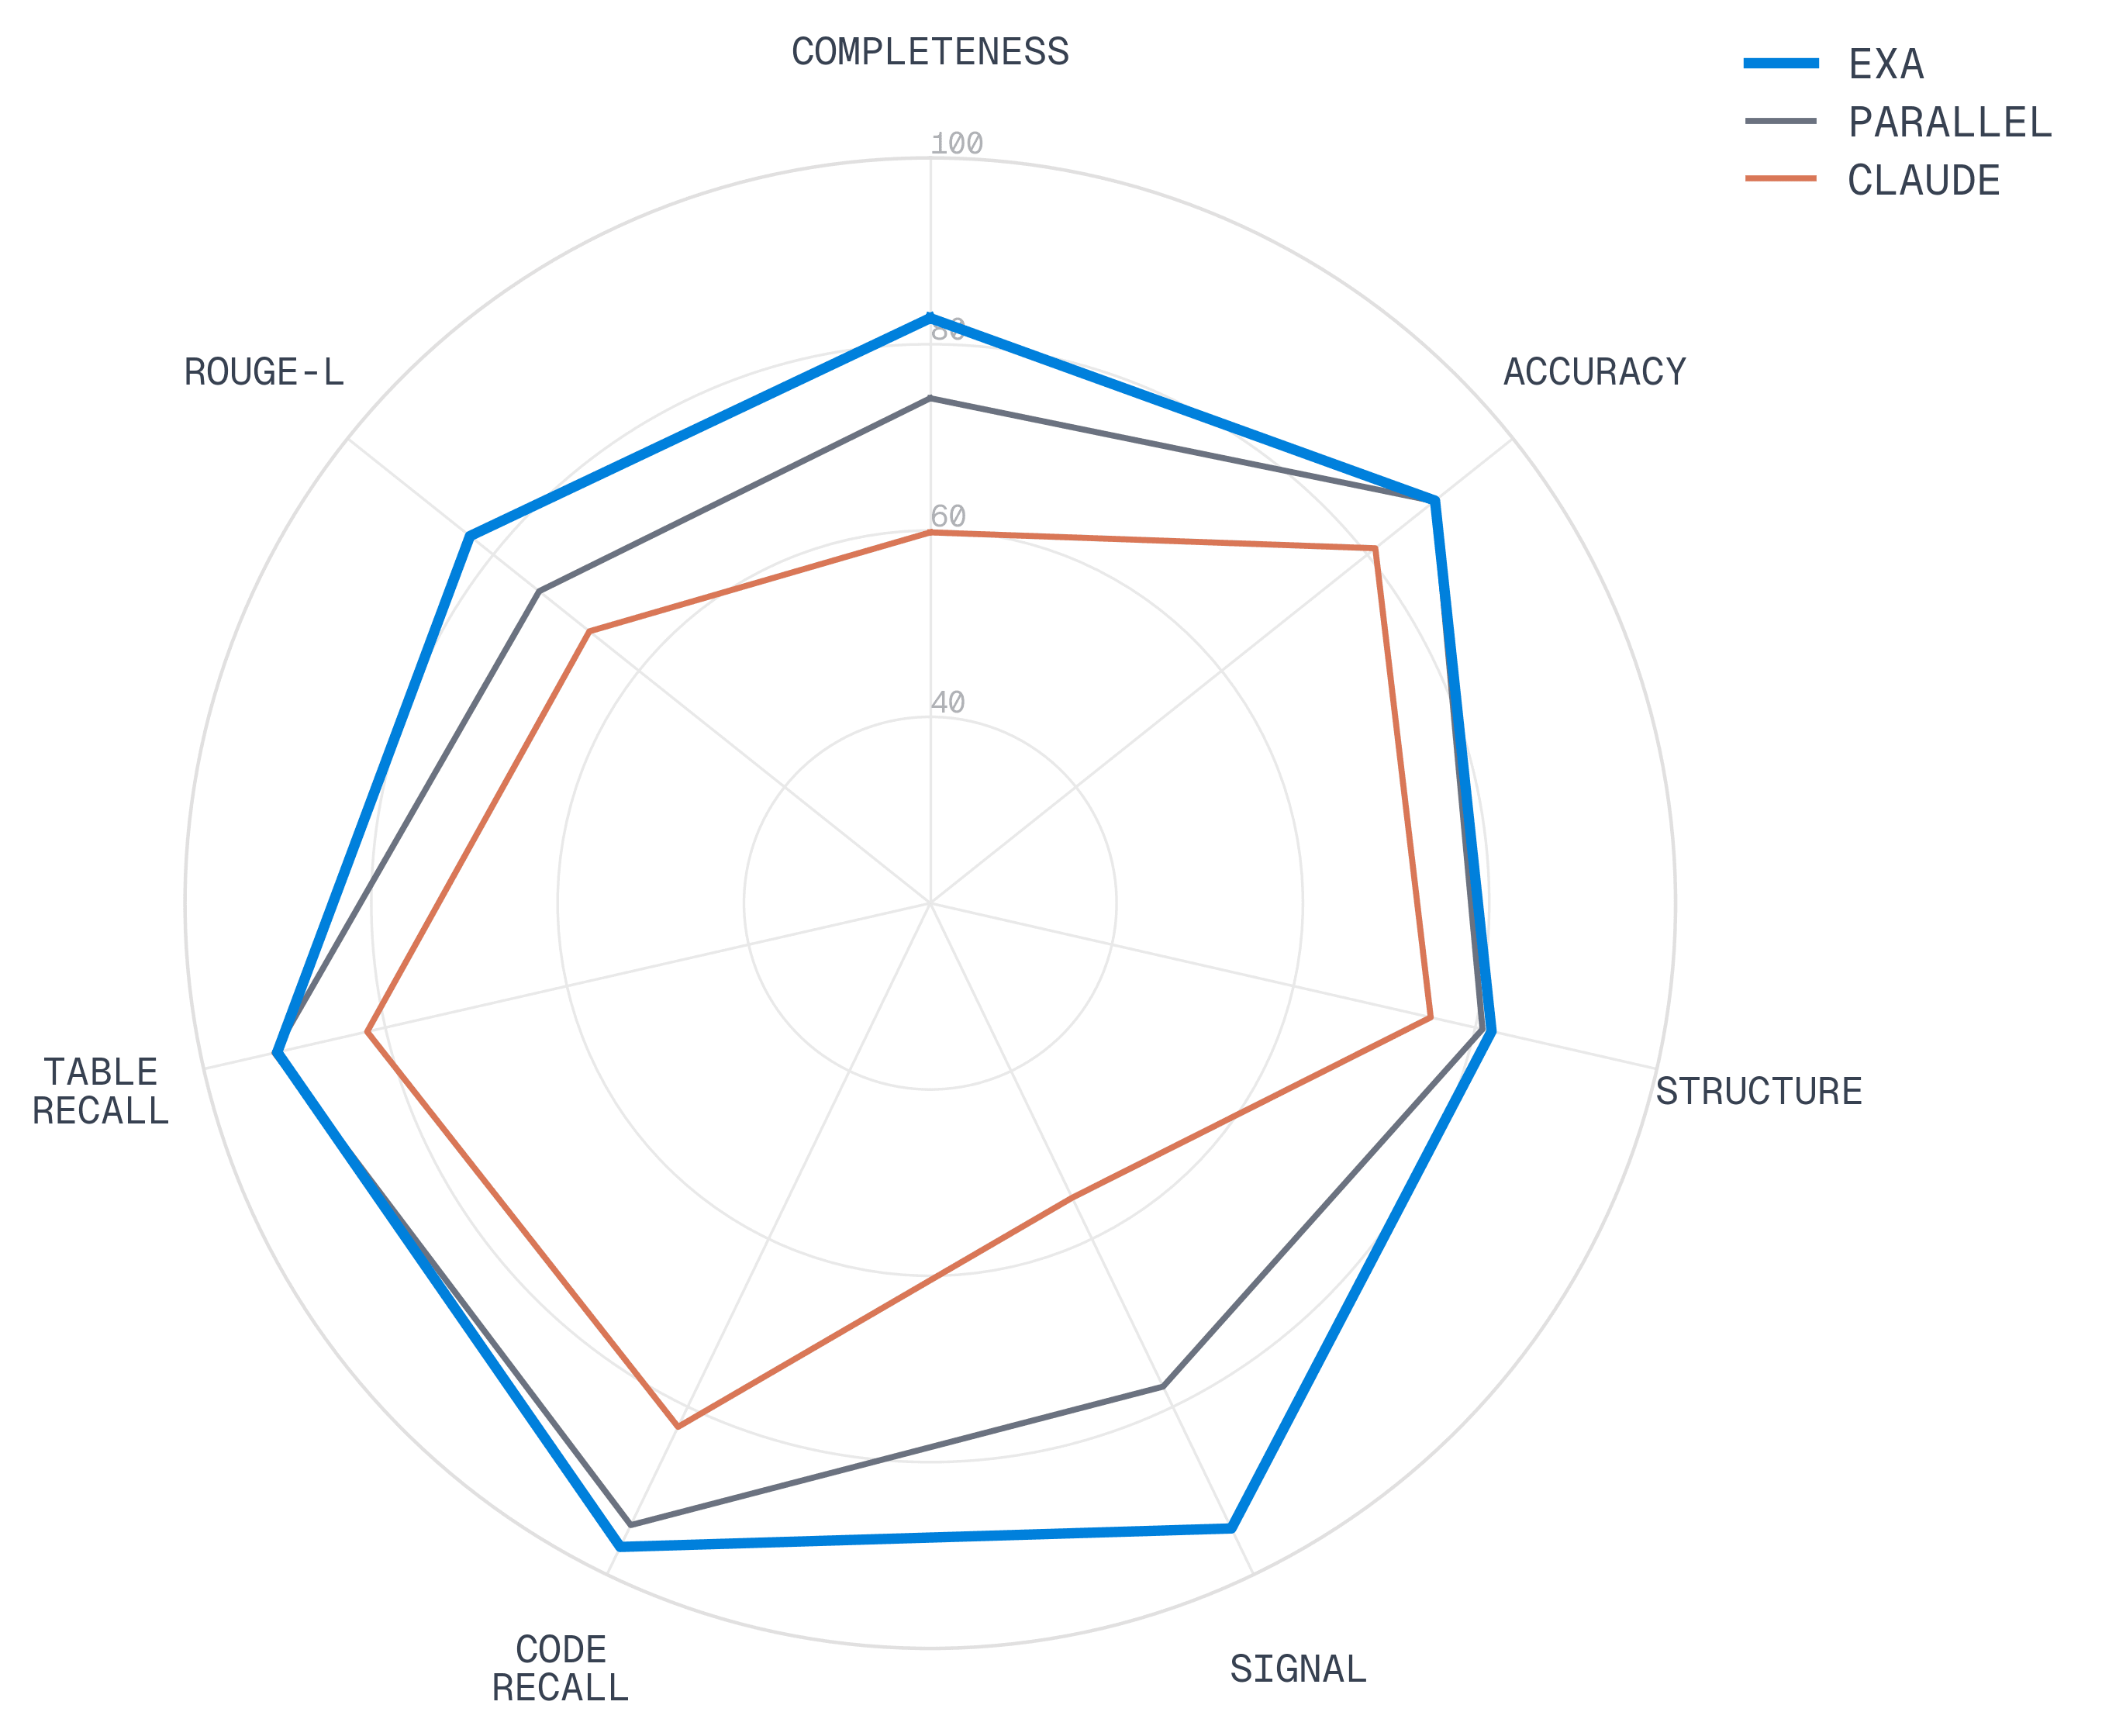
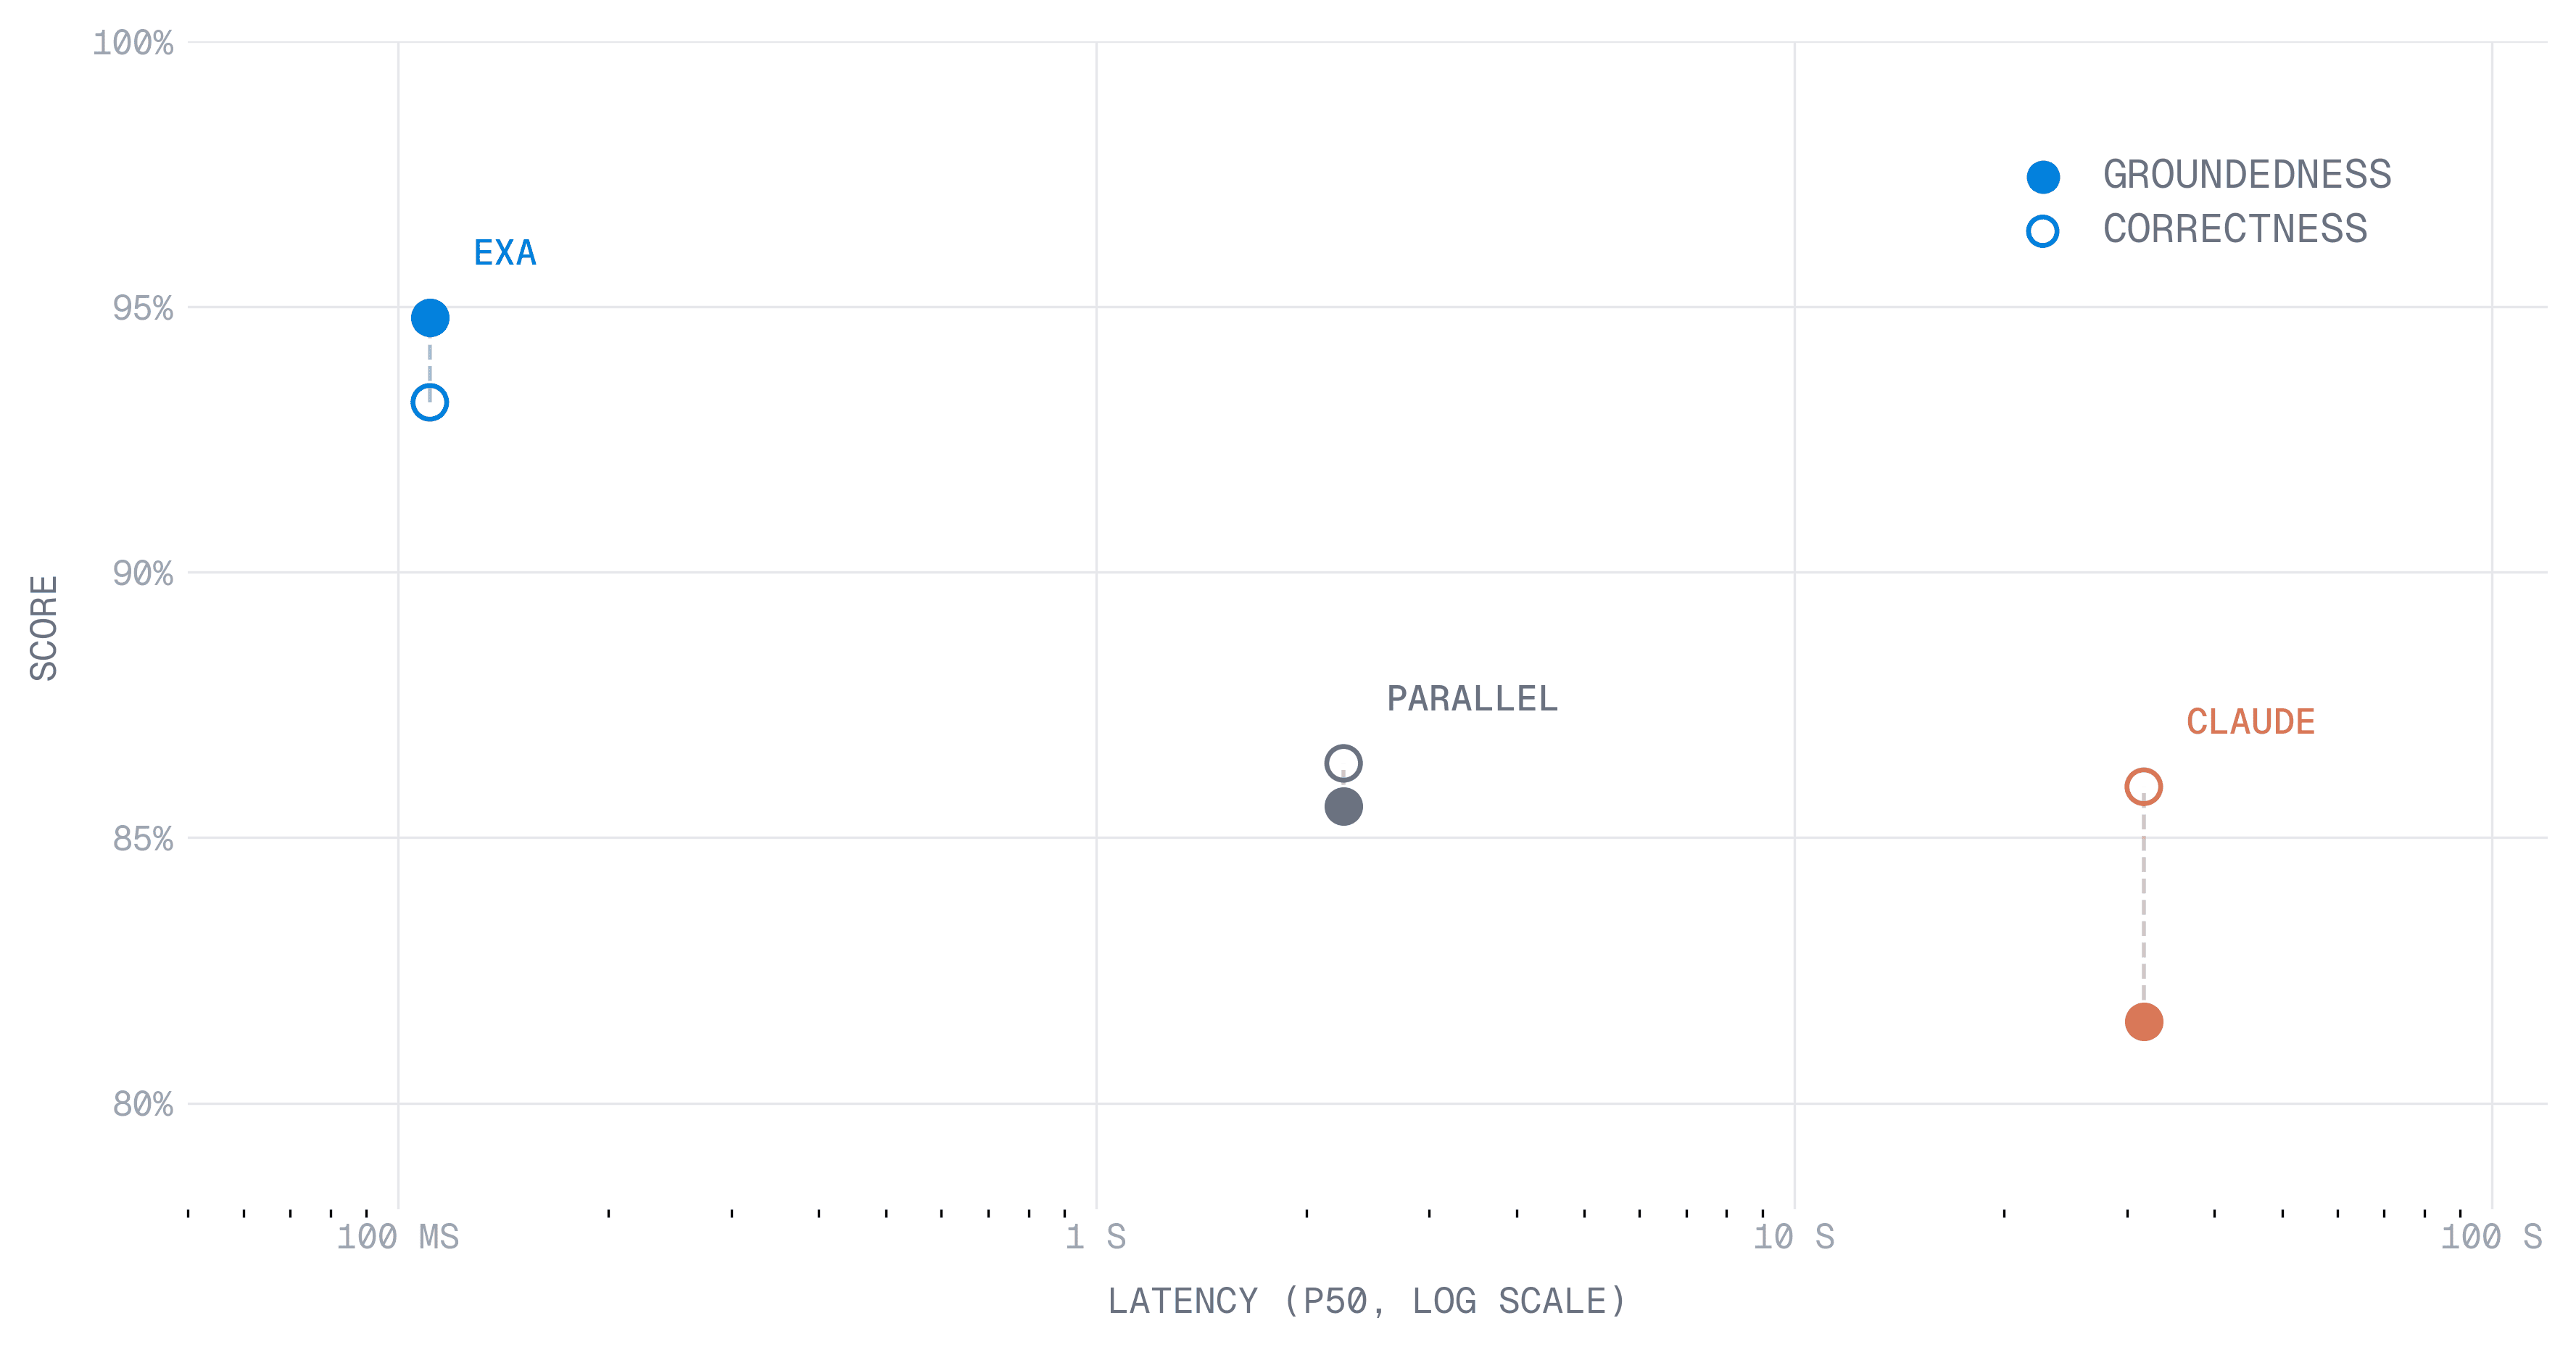
| プロバイダー | 完全性 | Signal | 構造 | 精度 | Code Recall | テーブル再現率 | ROUGE-L |
|---|---|---|---|---|---|---|---|
| DataSEO | 82.8 | 94.5 | 81.8 | 89.3 | 96.7 | 91.9 | 83.2 |
| コレクションの例 | 74.2 | 77.6 | 80.8 | 89.2 | 94.1 | 92.2 | 73.7 |
| Claude† | 59.8 | 55.1 | 75.1 | 81.1 | 82.4 | 82.0 | 66.8 |
各検出事項について、該当するURL、根拠、想定されるユーザーへの影響、具体的な修正方法を記録してください。確認済みの問題と、追加調査が必要な項目を区別してください。
内部リンクを確認する
仕上げに取りかかる前に、直接インデックス登録とナビゲーションの不具合を修正 軽微なメタデータ。順序は ビジネス上の重要度、影響、実装工数に基づいて、残りの作業に優先順位を付けます。
メタデータと重複を確認
修正後に関連するチェックを再実行して証拠を比較します。テストの成功が証明するのはチェック対象の動作であり、将来の検索順位を保証するものではありません。
チェックリスト:まず、主要なランディングページ、商品ページ、代表的なテンプレートなど、顧客にとって重要なURLから始めましょう。目的がクロール可能性、インデックス登録、コンテンツ品質、ページパフォーマンスのどれなのかを記録してください。
- ハイライトは誤っていましたが、統合LLMは正しい回答を返しました
- ハイライトは正しかったものの、統合LLMが誤った回答を返しました
チェックリスト:クロール設定を固定し、 明示的なページ上限。 クロールが早期に終了すると、サイト内のすべてのページが正常であるとは確認できません。
チェックリスト:日付入りの記録を保管 対象のレンダリングの 選択肢と収集ルート。 これにより、異なる条件で収集した結果を混在させず、後から比較する際にその根拠を説明できます。
- 調査が必要な対象と市場から始めます。各On-Page APIレスポンスとともに、ソースと収集時刻を保持してください。
- 検索可視性、需要、リンク、ページの健全性、AIの引用にまたがる調査では、On-Page APIに関連データセットを組み合わせてください。
レンダリングとパフォーマンスのテストを選択
チェックリスト:HTTPレスポンスを確認 ページコンテンツを読み取る前に。リダイレクト、エラーレスポンス、ブロックされたリクエストには、HTMLページの取得成功とは異なる調査が必要です。
チェックリスト:robotsを確認 メタタグとcanonical URLs in the returned ドキュメント。noindexディレクティブは検索結果から意図的に除外するものですが、 canonicalは優先URLを示しますが、 異なる課題を解決します。
修正を優先順位付けし、検証する
チェックリスト:テンプレートによって多くのURLで同じ問題が発生している場合は、代表的なページを手動で確認しましょう。レンダリング後の各ページを個別に編集するより、テンプレートを修正するほうが効果的な場合があります。
チェックリスト:リンク切れを、参照元ページとリンク先ごとに分類しましょう。ユーザーやクローラーが重要なコンテンツに到達できなくなるリンクを優先してください。
監査の対象範囲を定義する
ステータスとインデックス登録可能性を確認
チェックリスト:内部リンクのリンク先を優先URLの一覧と比較しましょう。リダイレクトの連鎖に頼らず、正規ページへ直接リンクしてください。
チェックリスト: 範囲を限定したクロールでページが見つからない場合、クロール範囲外の可能性があります。次を確認してください 独立してURLを確認してから 孤立ページまたは削除済みページと判定する。
チェックリスト:タイトルを確認 および正確に特定する説明。 各ページの目的。同じ一般的な記述をすべての商品ページで繰り返すのは ユーザーの役に立たない 両者を区別してください。
内部リンクを確認する
チェックリスト:重複候補を主要なコンテンツと意図に基づいて比較しましょう。統合するか、廃止したルートをリダイレクトするか、真に異なる情報を提供するページを作成するかを判断してください。
チェックリスト:内部リンク、canonicalタグ、サイトマップで、同じ優先URLを使用しましょう。シグナルが食い違うと、意図したURLが判別しにくくなります。
チェックリスト:必要なコンテンツを取得できる、最もシンプルな収集方法から始めましょう。JavaScriptに依存するテンプレートではブラウザーが必要な場合がありますが、ブラウザーでの収集には異なるリソース要件があります。
- クロールの問題を種類と優先度ごとに分類し、修正後に該当URLを確認します。
-
キーワード、検索エンジン、地域、言語、デバイスを設定します。各観測でこれらの設定を保持することで、ランキング比較の対象を同じオーディエンスと市場に揃えられます。
- オーガニック検索、マップ、ニュース、画像、ショッピング、その他の対応する検索結果タイプを調査します。アイテムタイプを使って、各エンドポイントが返すフィールドを解釈します。
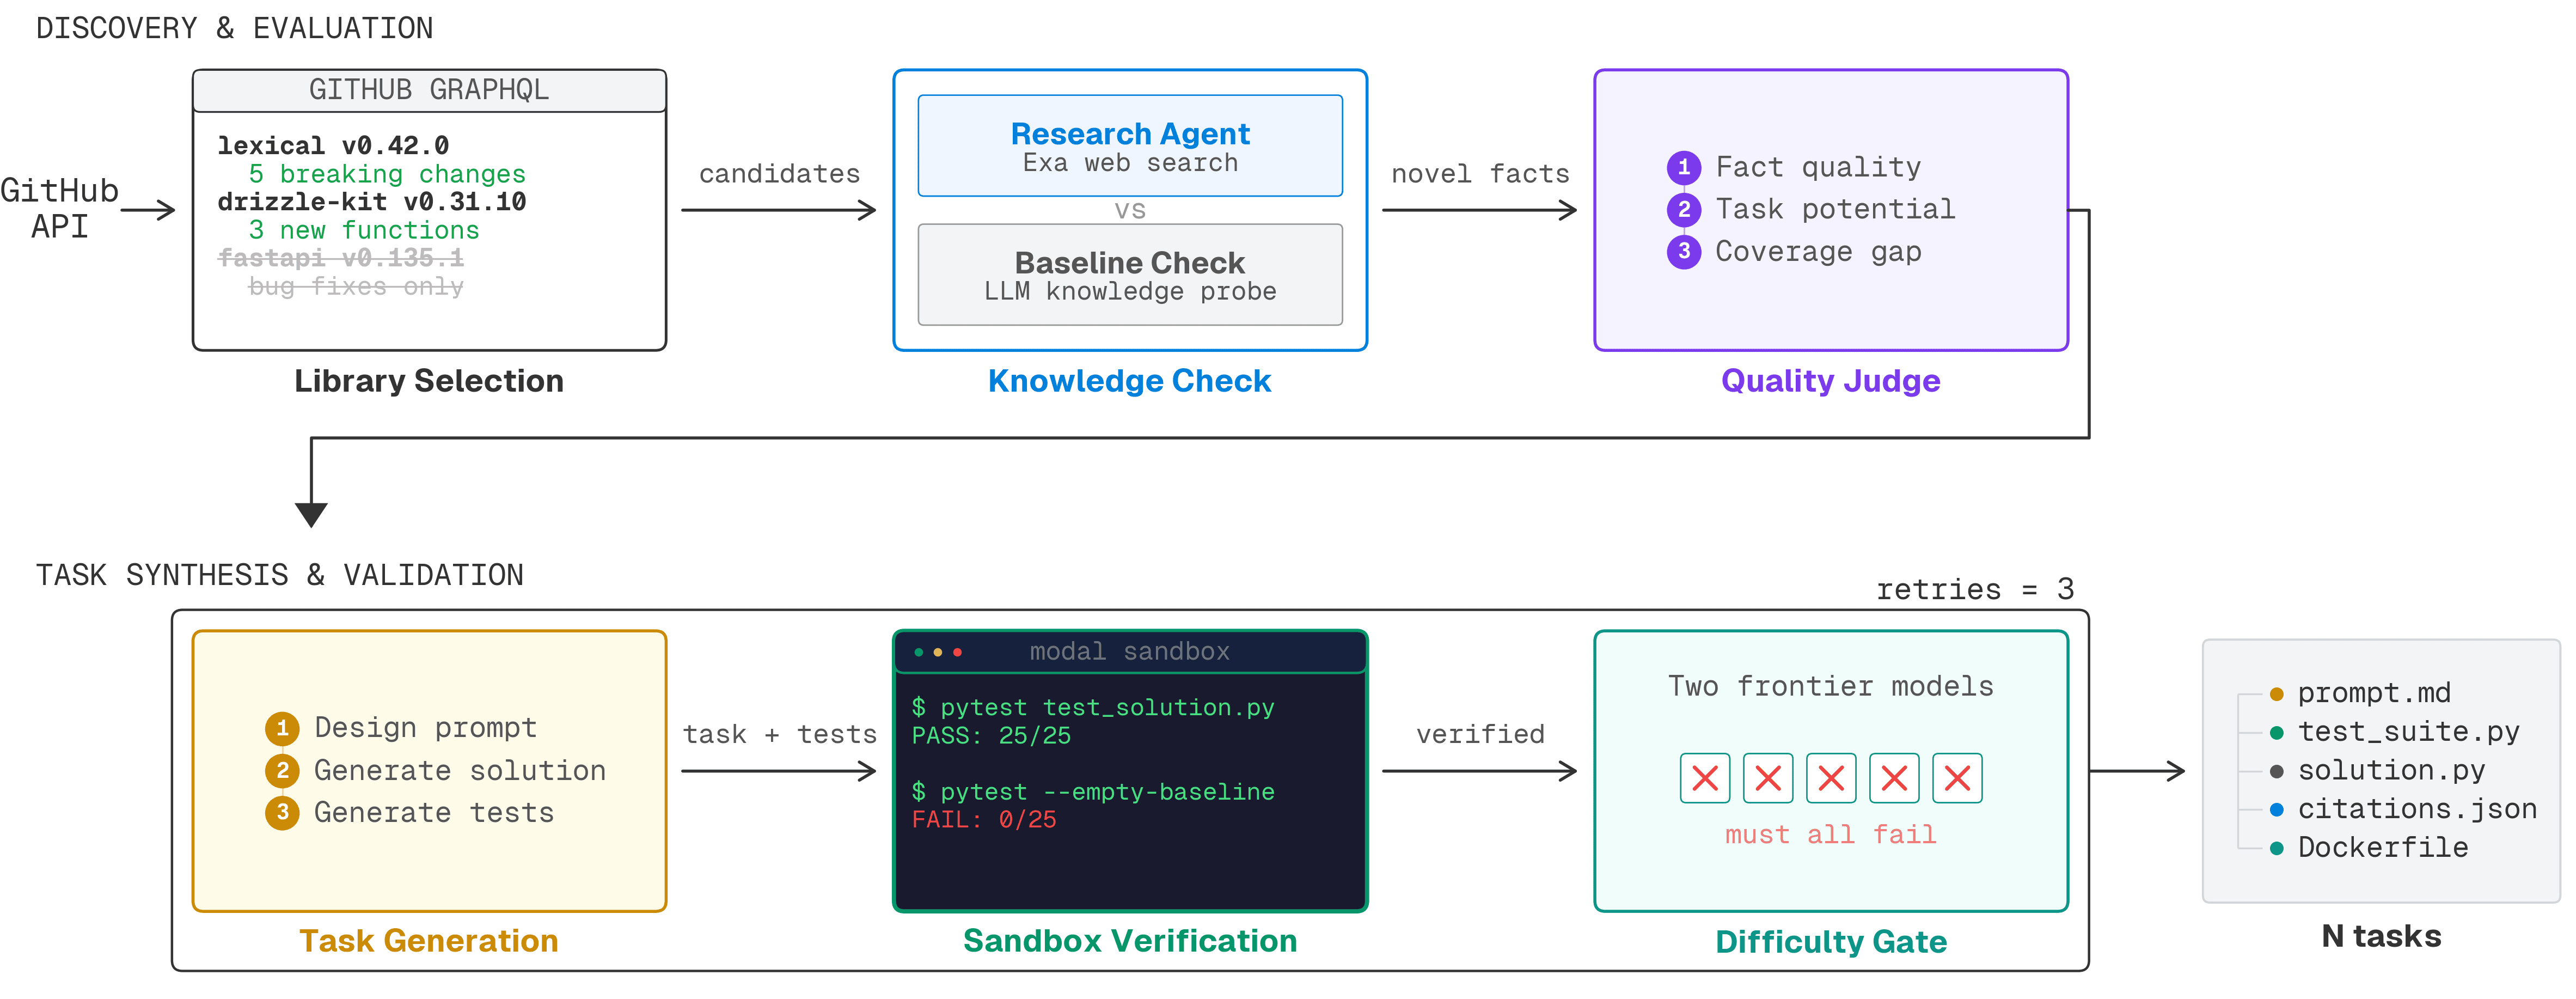
- タスク生成: 新たな事実を使って、タスクのプロンプト、解決策、テストスイートを生成しました
- いいえ。確認するサイトに合わせて、レンダリングと監査のオプションを選択してください。追加処理によって、収集コストや速度が変わる場合があります。
- 調査が必要な対象と市場から始めます。各On-Page APIレスポンスとともに、ソースと収集時刻を保持してください。
チェックリスト:Lighthouseの結果は、特定の条件下で実行されたラボテストとして解釈しましょう。フィールド測定なしに、その結果を実ユーザーのCore Web Vitalsとして報告しないでください。
チェックリスト:読み込みの問題を調査するときは、画像、フォント、サードパーティのリソースを確認しましょう。リソースを変更した後は、同じページを同等の条件で再テストしてください。
メタデータと重複を確認
チェックリスト:各所見について、該当URL、証拠、想定されるユーザーへの影響、具体的な修正方法を記録しましょう。確認済みの問題と、さらなる調査が必要な疑問を区別してください。
チェックリスト:軽微な問題を整える前に、インデックス登録とナビゲーションに関する直接的な不具合を修正しましょう。 On-Page APIを詳しく見る → ビジネス上の重要度、影響度、実装工数に基づいて。
チェックリスト:修正後に関連するチェックを再実行し、証拠を比較しましょう。テストの成功は、確認した動作を立証するものであり、将来の検索順位を保証するものではありません。
募集中の職種を見る-
1
.
実際の運用では: 顧客にとって重要なURL、つまり主要なランディングページ、製品ページ、代表的なテンプレートから始めます。目的がクロール可能性なのかを記録します。 インデックス登録、コンテンツの品質、またはページのパフォーマンス。
監査の対象範囲を定義する
実際の運用では: 固定のクロール設定と明示的なページ上限を使用します。途中で停止したクロールでは、サイト内のすべてのページが正常であるとは確認できません。
ステータスとインデックス登録可能性を確認
実際の運用では: 対象、レンダリング設定、収集経路を日付付きで記録します。こうすることで、異なる条件で収集した結果を混在させず、後日の比較を説明可能にできます。
内部リンクを確認する
実際の運用では: ページのコンテンツを読む前にHTTPレスポンスを確認します。リダイレクト、エラーレスポンス、リクエストのブロックは、正常なHTMLページとは異なる調査が必要です。
メタデータと重複を確認
実際の運用では: 返されたドキュメントのrobotsメタタグとcanonical URLを確認します。noindexディレクティブは検索対象から意図的に除外するもので、canonicalは優先するURLを示します。両者の役割は異なります。